Beiträge von Melegrian

    So, motion16 getestet.

    Zuerst das Positive. Sowohl Nano Banana 2.1, dem aktuellen Nachfolger von Nano Banana 2, als auch GPT 2.5 sind kostenlos verfügbar und halten sich wesentlich besser an meinem alten Prompt vom Frühjahr 2026. Keine Kutschen mehr auf dem Gehweg, so wie noch vor einem halben Jahr. Ob eine Straße in diesem Winkel in Richtung des Triumphbogens zuläuft, weiß ich nicht. Nano Banana 2.1 lieferte 4K in 16:9 mit 5504 x 3072 Pixel, GPT 2.5 blieb bei 1672 x 941 Pixel.

    Mein alter Prompt:

    "A photorealistic scene, a young, attractive woman in traditional Rococo folk costume strolls along the cobbled sidewalk of the Champs-Élysées in Paris. Dye the dress burgundy with yellow in the neckline. She is clearly the main subject. The street, also paved with cobblestones, shows only a few horse-drawn carriages in the background, which appear as minor details. The sidewalks are lined with trees with green leaves under a light blue sky with a few clouds. The style is Rococo and set in the 18th century."

    Nano Banana 2.1, ob die Credits sich täglich auffüllen, bleibt abzuwarten.

    Nano Banana Pro ist in einigen Bereichen besser als Nano Banana 2.1, doch im Test ging es mir nur um die mögliche Größe. Aktuell ist aber GPT 2.5 noch eine Idee besser, wie das nachfolgende Bild beweist, würde ich meinen, wenn man davon absieht, das ich im Prompt nicht ausdrücklich Full Shot (von Kopf bis zu den Füßen) geschrieben hatte.

    GPT 2.5

    Die Auswahlmöglichkeiten für Images und Videos sind übersichtlich.
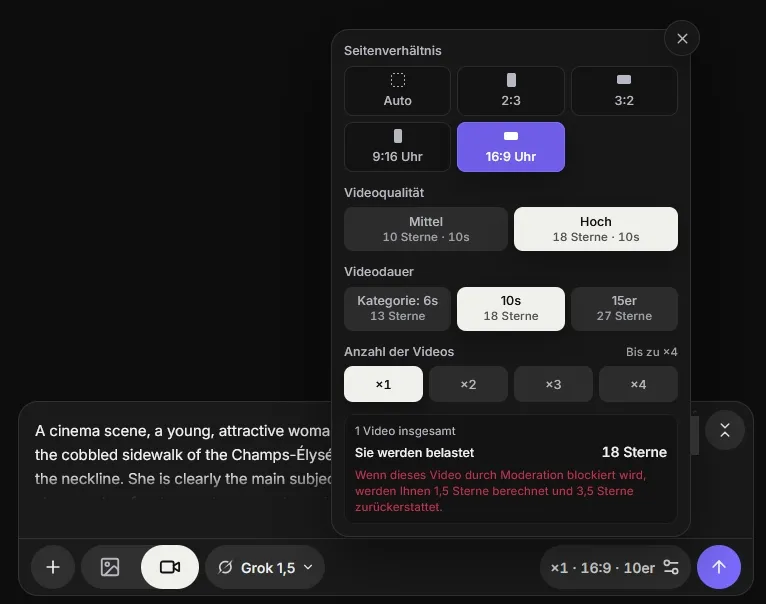
    Die Video-Modelle hauen mich nicht vom Hocker, nun Wunder habe ich auch nicht in diesem Fall erwartet. Von MiniMax hörte und sah ich bereits einiges, was Silent Motion (Stille Bewegung) bringen soll, weiß ich nicht, im Clip blieb alles still und bewegungslos. Im Gegensatz zu diesem Screenshot, hat Meta dafür die Pause augenblicklich beendet, wie ich grade sah und möglich sind 5/5 steht nun dort.

    Jedenfalls wollte ich ein Paket mit 150 Sternen für $ 3,00 nehmen, und dann begann die Krise. Es öffnete sich eine Seite von Telegram im Webbrowser auf dem Computer, einen Bot sollte man starten, nur der rührte sich nicht. Die Google KI versicherte mir, dass Sterne das bevorzugte Zahlungsmittel bei Telegram wäre und alles seine Richtigkeit hätte. Doch ich wurde unsicher, weil ich im Browser nicht einmal mehr in meinem eigenen Telegram Kanal kam, den ich im März angelegt hatte, und nichts zum Einloggen fand. Also nichts für alte Leute, die nach einem halben Jahr vergessen, dass sie dafür vor einem halben Jahr eine App auf dem Handy eingerichtet hatten, die nicht an Vergesslichkeit leidet. An der war es dann möglich, eine Nachricht zu senden und einen Code zu erhalten, mit dem man sich wieder im Webbrowser auf dem Computer einloggen konnte.
    Danach die Webseite von motion16 auf dem Handy aufrufen, sein gewünschtes Sternepakt auswählen, den Telegram Bot starten, und es meldet sich Google Play Store (Android) oder Apple App Store (iPhone), also der Store, über die man einst seine Telegram App installierte. Vollkommen sicher nach der Google KI, hatte selbst zumindest auch noch nie Probleme in dieser Richtung dabei, obwohl ich auch andere Zahlungen darüber zu laufen habe. Aber was ist heute noch vollkommen sicher, habe da selbst oft Zweifel.

    Der fertige Clip von MiniMax hat eine Größe von 1216 x 672 Pixel, was nicht berauschen viel ist und noch unter einfachen HD liegt. Die Pferde der weiter hinten fahrenen Kutschscheinen über den Fahrbahnbelag mit unsichtbaren Kufen zu gleiten. Die Kosten umgerechnet 15 Sterne und somit 10 % von 150 errworbenen Sternen zu 3 Dollar.


    Der Prompt für den Clip, der erste Teil mit "zoom out" bis "Full Shot" (von Kopf bis zu den Füßen) wurde nicht:

    "The Parisian woman in the picture is strolling along the Champs-Élysées in Paris around the year 1800. The camera first zooms out slightly until it has a full-shot view of the woman from head to toe. . Then the camera keeps dollying back, maintaining the distance as the woman approaches."

    Zum Schnuppern für Videos gut, für Images sogar sehr gut, denke ich.

    Externer Inhalt www.youtube.com
    Inhalte von externen Seiten werden ohne Ihre Zustimmung nicht automatisch geladen und angezeigt.
    Durch die Aktivierung der externen Inhalte erklären Sie sich damit einverstanden, dass personenbezogene Daten an Drittplattformen übermittelt werden. Mehr Informationen dazu haben wir in unserer Datenschutzerklärung zur Verfügung gestellt.

    Eigentlich ist der Zeitraum etwas vor dem Jahre 1800, in dem die Epoche des Rococo mit dieser Kleidung endete, aber ich habe es immer so geschrieben.
    Es gibt sehr viele News, was zum Teil gar keine sind, nur für mich, weil ich mich erst in sehr vielen Tutorials vertieft habe.

    Aber was ist nun neu?

    Keine Frage, das Wettrennen geht weiter.

    Kling 4.0, bisher nur in den teuersten Plänen ausgerollt, soll in den nächsten Wochen wohl auch allgemein zur Verfügung stehen.

    Bisher war es so, entweder Images für Start- und Endframes oder mit Image Referenzen Video Clips erstellen, aber nicht beides gleichzeitig beides. Nun neu bei Modell 4.0, die Längen von Clips von 15 auf 30 Sekunden erhöht, um mit Sedannce 2.5 aufzuschließen und die Reihenfolge kann nun sein, Images für Startframes, Keyframes und Endframes zu kombinieren, womit die Konsistenz von Charakteren und Umgebungen erhöht werden kann.

    Bis 30 Sekunden am Stück zu generieren, würde nichts bringen, weil Filme nun einmal von Schnitten leben, zumindest von wechselnden Kameraeinstellungen. Nicht neu ist, dass es dafür Bilder mit Gridsystem fertigen lassen, in der Regel 3 x 3, um daraus 6 Einzelbilder für Start- und Endframes zu schneiden. Die Empfehlung war bisher dabei, fürs Grid mindestens 4K zu verwenden. Nun, oder erst jetzt sah ich, dass Leonardo für Nano Banana Pro bis 5504 × 3072 Pixeln anbietet, was zwar noch nicht an 8K heranreicht, jedoch deutlich größer als 4 K ist. Die Einzelbilder würden mit 1834 × 1024 Pixel beinahe Full HD entsprechen.

    Dann über ein weiteres Tutorial gestolpert. Die meisten Pläne sind abschreckend, wozu teure Abonnements, wenn ungenutzte Credits am Monatsende verfallen. Leonardo ist hier mehr eine Ausnahme, wo diese bis zu 3 Monate gesammelt werden können. Eine weitere Ausnahme, motion16, kein Abo, sondern kleine Pakete ab $ 1.99 zum Einmalpreis. Habe mich noch nicht dort registriert, werde es aber machen, denke ich, zumal es dort auch kostenlose Angebote gibt.

    Zusammenfassend würde ich sagen, Kling 4.0 wäre bestimmt auch für User interessant, die ihre 3D Szene mit mehr als einem Enzelrender animieren möchten, und motion16, für User, die nur einmal Schnuppern möchten, ohne gleich ein Abo abzuschließen.


    Nicht ganz neu, Gridsystem für konsistente Character & Scenen

    Externer Inhalt www.youtube.com
    Inhalte von externen Seiten werden ohne Ihre Zustimmung nicht automatisch geladen und angezeigt.
    Durch die Aktivierung der externen Inhalte erklären Sie sich damit einverstanden, dass personenbezogene Daten an Drittplattformen übermittelt werden. Mehr Informationen dazu haben wir in unserer Datenschutzerklärung zur Verfügung gestellt.

    Sind beide mit einem deutsprachigen Audio auswählbar.

    Video ist zumindest ganz neu - motion16

    Externer Inhalt www.youtube.com
    Inhalte von externen Seiten werden ohne Ihre Zustimmung nicht automatisch geladen und angezeigt.
    Durch die Aktivierung der externen Inhalte erklären Sie sich damit einverstanden, dass personenbezogene Daten an Drittplattformen übermittelt werden. Mehr Informationen dazu haben wir in unserer Datenschutzerklärung zur Verfügung gestellt.

    Rotkäppchen reitet durch den Wald. Den Galopp bekommt Seedance etwas besser fertig, doch die Auflösung beließ ich bei 720p, weil bei 1080 meine Credits kaum gereicht hätten. Die Kosten sind ja mehr als doppelt so hoch, gegenüber z.B. Kling AI. Flow kam ebenfalls mit dem Galopp klar, Clips mit 1080p sind kein Problem, doch die Gesichter waren bei etwas größerer Entfernung sehr entstellt.

    Externer Inhalt www.youtube.com
    Inhalte von externen Seiten werden ohne Ihre Zustimmung nicht automatisch geladen und angezeigt.
    Durch die Aktivierung der externen Inhalte erklären Sie sich damit einverstanden, dass personenbezogene Daten an Drittplattformen übermittelt werden. Mehr Informationen dazu haben wir in unserer Datenschutzerklärung zur Verfügung gestellt.

    Letztes Video, 20 Aufrufe wurden angezeigt, unter der Haube nur 16, braucht nicht daran zu liegen, dass mein oder Lickes Geschmack so schlecht ist. Ein wesentlicher Hauptgrund könnte eher sein, dass die Zielgruppe eine völlig andere ist, bei der YouTube gar nicht auf die Idee kommt, meine Videos auszuliefern. Wer slawische Volkslieder für ältere Besucher mag, wird sich nicht so etwas unbedingt anhören.

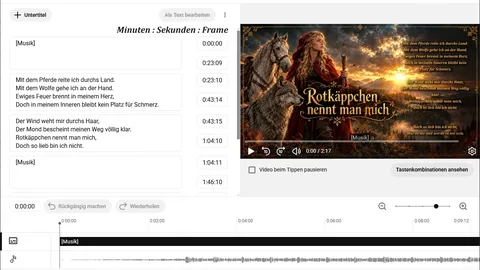
    Dann hatte die halluzinierende KI von YT den Songtext für Englisch gehalten, dementsprechend einen Bullshit als Untertitel auf Englisch generiert. Wollte selbst auf Deutsch eintragen, doch meine Zahlen wurden stetig torpediert und völlig verdreht. Die Google KI war keine große Hilfe, kam dann allein drauf.

    Es sind "Minuten : Sekunden : Frames", und zwar die FPS, mit denen das Video hochgeladen wurde. und man sollte nicht mehr als zwei Zeilen in einem Feld notieren, vier geht gerade noch so, weil zusammengehörige Zeilen auf einmal angezeigt werden. Nun habe ich es halt gelernt, doch wem es interessiert, sollte sich das Beispiel anschauen.

    Die Erstellung einer sauberen Schleife für Shorts war denkbar schlecht, weil sich Musik und Gesang sich nicht sauber trennen lassen am Anfang wie Ende, auch nicht durch Stems.

    Hierfür habe ich länger gebraucht, als erwartet. Zuerst ein Bild erstellen, die ersten 4 Entwürfe waren gleich erneut mit geschlossenen Augeliedern, damit keine Video KI weiß, wie sie mit offenen Augen aussieht. Über 20 letztendlich gemacht. Dann in Kling, erster Clip mit Lip Sync mit dem Lächeln eines Honigkuchenpferdes, Warum denken alle KIs immer, Menschen müssten stets lächeln? Den zweiten Clip habe ich dann genommen.

    Externer Inhalt www.youtube.com
    Inhalte von externen Seiten werden ohne Ihre Zustimmung nicht automatisch geladen und angezeigt.
    Durch die Aktivierung der externen Inhalte erklären Sie sich damit einverstanden, dass personenbezogene Daten an Drittplattformen übermittelt werden. Mehr Informationen dazu haben wir in unserer Datenschutzerklärung zur Verfügung gestellt.

    Wird wohl nicht viel besser laufen als das eigentliche Video, die Wegwischrate ist bereits jetzt viel zu hoch, also keine Chance.

    Ganz nebenbei, gestern gehört, heute noch einmal gelesen. Ein US-Amerikaner hatte rund 8,1 Mio Dollar mit KI Musik verdient, nun muss er dafür 18 Monate in Haft und soll zusätzlich noch das Geld zurückzahlen. Um genug Umsatz zu generieren, musste er zuerst tausende Sounds generieren, dann Fake Accounts bei Streamingplattformen anlegen, um auf denen seine Bots zu installieren, die Milliardenfach seine Musik streamten. Dadurch hörten bis zu 10.000 Bots seine Musik gleichzeitig, und streamten seine Musik rund 80,9 Millionen Mal. Allein Fleiß macht sich nicht immer bezahlt, oder, wie in diesem Fall, nur kurzfristig.

    Mein letztes Video wird niemanden erreichen, wenn ich mir nicht ebenfalls etwas einfallen lasse. Anders als bei Shorts gibt es für Videios im Querformat keine Testphase, um eine Zielgruppe zu suchen, und die Mehrheit meiner Abonnenten mögen andere Musik. Es könnte somit das mit den schlechtesten Aufrufzahlen bisher werden.

    Habe das an Animationen fertig hatte, sind teilweise nicht die besten geworden, doch ich wollte nicht noch mehr Credits verbrauchen. Für diesen Zweck sollte es bald genügen, auch wenn es sicherlich noch besser ginge. Bisher war noch kein automatisch hinzugefügtes KI-Zeichen zu sehen, ausgewält habe ich auch nichts bei den Optionen, in der Beschreibung aber unter dem Video angegeben.

    Edit: YouTube hat die Auswahl um Punkt vier erweitert, nun musste ich es doch auswählen, muss neu sein:

    Verwendung von KI

    Wurde KI zum Generieren oder Bearbeiten deiner Inhalte auf eine der folgenden Arten verwendet?

    • Eine echte Person sagt oder tut darin etwas, was sie nicht gesagt oder getan hat
    • Aufnahmen eines realen Ereignisses oder Ortes werden verändert
    • Es wird eine realistisch anmutende Szene generiert, die nicht wirklich stattgefunden hat
    • Erstellt Musik, die im Mittelpunkt des Videos steht

    Beim Hexevideo brauche ich es nicht nachholen, da steht die Musik nicht im Mittelpunkt, bei der Fee am Piano ebenfalls nicht.

    Externer Inhalt www.youtube.com
    Inhalte von externen Seiten werden ohne Ihre Zustimmung nicht automatisch geladen und angezeigt.
    Durch die Aktivierung der externen Inhalte erklären Sie sich damit einverstanden, dass personenbezogene Daten an Drittplattformen übermittelt werden. Mehr Informationen dazu haben wir in unserer Datenschutzerklärung zur Verfügung gestellt.

    Nun fehlt wenigstens noch ein Short Video.

    Gestern viel Ausschuss produziert. Aufs Pferd aufsteigen, hat weder die Video-KI von Flow noch Kling geschafft. Das wurden immer eher Lachnummern, nur dass die bei Kling echte Credits kosten. Habe jetzt keine Lust Clips hochzuladen, wo die Video KI z.B. die vorhandenen Steigbügel nicht erkennt, die Frau deshalb ihren Fuß auf einen nur gedachten unsichtbaren Steigbügel stellt, dann noch schnell die Beine vertauscht werden. Und Kling weiß, neben dem Aufsteigen, scheinbar noch immer nicht, wie ein Galopp bei Pferden aussieht, es erinnert wieder mehr an schnell hoppelnde Hasen. In einem Clip wurde der Galopp gar nicht so sehr verkehrt, doch da ist die Frau und Pferd so weit von der Kamera entfernt, viel zu klein für ein Video.

    Ganz verstehe ich es nicht, weil die Clips für Homay und Tibet bessser hinhauten mit dem Reiten. Nun ja, der Image KI erklärt, wo die Steigbügel im Referenzbild gut sichtbar sind, dann zuerst ein Startbild fertig gemacht, wenigsten das funktionierte.

    Please place the woman Woman walking 01 on her horse so that her boots are also in the stirrups already visible in the picture; the stirrups are also clearly visible on both sides of the middle horse in the reference image Horse reference 01 .

    Bitte platzieren Sie die Frau Frau 01 auf ihrem Pferd so, dass ihre Stiefel ebenfalls in den bereits im Bild sichtbaren Steigbügeln sind; die Steigbügel sind auch auf beiden Seiten des mittleren Pferdes im Referenzbild Pferd Referenz 01 deutlich zu erkennen.

    Das hat zumindest die Image KI begriffen, so das erst einmal ein Ausgangsbild vorhanden ist, nur der Clip davon wurde nur 8 Sekunden, was ja nur ein Anfang sein kann.

    Thinking ist bei chat kein Modell, wieviel Rechenkraft zur Verfügung gestellt wird...

    Wenn du es genau wissen möchtest, Thinking ist ein Reasoning-Modell. Ja, bei ChatGPT vermutlich nur ein Modus, stimmt. Einfache oder ältere LLM könnten es aber vermutlich gar nicht anders, als das Modell zu wechseln.

    Google KI:

    Das Modell (Die Basis): Die zugrundeliegende KI ist ein sogenanntes Reasoning-Modell (oder Thinking-Modell). Das bedeutet, das Sprachmodell wurde speziell dafür trainiert und optimiert, vor der eigentlichen Ausgabe einen internen, mehrstufigen Denkprozess (Chain-of-Thought) durchzuführen.

    Die Einstellung (Der Schalter): In Apps wie ChatGPT, Gemini oder Claude fungiert „Thinking“ oft als Einstellung, Schalter oder Modus (z. B. Fast vs. Thinking oder die Wahl des Denk-Budgets), mit dem Sie der KI erlauben oder vorschreiben, diesen rechenintensiven Denkprozess für Ihre Anfrage zu nutzen. Bei manchen neueren Modellen ist dieser Denkmodus auch fest integriert und passt sich adaptiv an die Schwere der Aufgabe an.

    Die Bezeichnungen vergesse ich wieder.

    Endlich den ersten Clip von 10 Sekunden, der akzeptable wurde. Die Video KIs akzeptieren bisher nur Bilder für Start- und Endframes oder Referenzbilder, nicht beides zusammen. Seedance vielleicht, doch alle anderen nicht. Nun hatte sie im ersten Startbild die Augenlider geschlossen, ihr Blick wird sicherlich abweichen. Und Google Flow nimmt trotz Omni 1.1 Flasch nur Start- und Endframes. Könnte jetzt höchstens nach Kling wechseln.

    The woman is walking her horse in the meadow, followed by a tame wolf. The horse's saddle blanket is simply made of thick brown fur. It is evening, shortly before sunset.
    The camera keeps dollying back, maintaining the distance as the woman approaches.

    Der letzte Satz hab zumindest gut geholfen, damit die Kamera zurückfährt, je näher sie dieser kommt.

    Habe bei ChatGPT gar kein anderes Modell als "Nachdenken" zur Auswahl, sehe ich gerade. Müsste sich bei anderen Anbietern Thinking oder ähnlich nennen.

    Nun Flow, ja, wollte den Gesichtsausdruck korrigieren lassen:

    Her facial expression should be relaxed and thoughtful, conveying inner contentment. No laughing!

    The rest of the picture should remain exactly as it is.

    Nun hat sie den Mund geschlossen, grinst aber vor sich hin. Neuer Versuch mit "Nicht lachen! Nicht grinsen!"

    Her facial expression should be relaxed and thoughtful, conveying inner contentment. No laughing! Don't grin!

    The rest of the picture should remain exactly as it is.

    Jetzt schaut sie normaler, nicht so gut wie bei Chat, aber normaler als vorher.

    da wirst du ganz sicher auch schon so manches mal geflucht haben, weil die KI einfach nicht das macht, was man will..

    Das Fluchen über KIs kennt wohl jeder, der versucht damit ernsthaft zu arbeiten und nicht mit den ersten Zufallsergebnissen zufrieden ist. Einzig nach einer gewissen Zeit der Besinnung überlege ich mir dann, was sich verbessern lässt. So bin ich zwar aktuell noch nicht weitergekommen, Vibes von Meta hat die bei den letzten Versuchen wie einen betrunkenen Trampel durch die Gegend laufen lassen, rendert aber stetig vier Clips gleichzeitig, nur ein brauchbarer war nicht bei. Allein die Bilder haben mir, beim Versuch einen Clip davon einzufügen, nicht mehr von der Stimmung gefallen. Und Flow Clips ließen sich nicht verlängern, wenn Beteiligte an der Kamera vorbeilaufen und nur noch von hinten zu sehen sind. Da könnte ich aber noch versuchen, dem Kameramann die richtige Anweisung zu geben. Die Liste mit den Fachbezeichnungen hat mir dabei zuweilen geholfen.

    Aber erst einmal neue Ausgangsbilder. Also KI Frage ich nur in Notfällen, überlegt, was möchte ich ändern. Prompt auf Deutsch, [1] usw. nach dem Einfügen durch @ in Flow ersetzen:

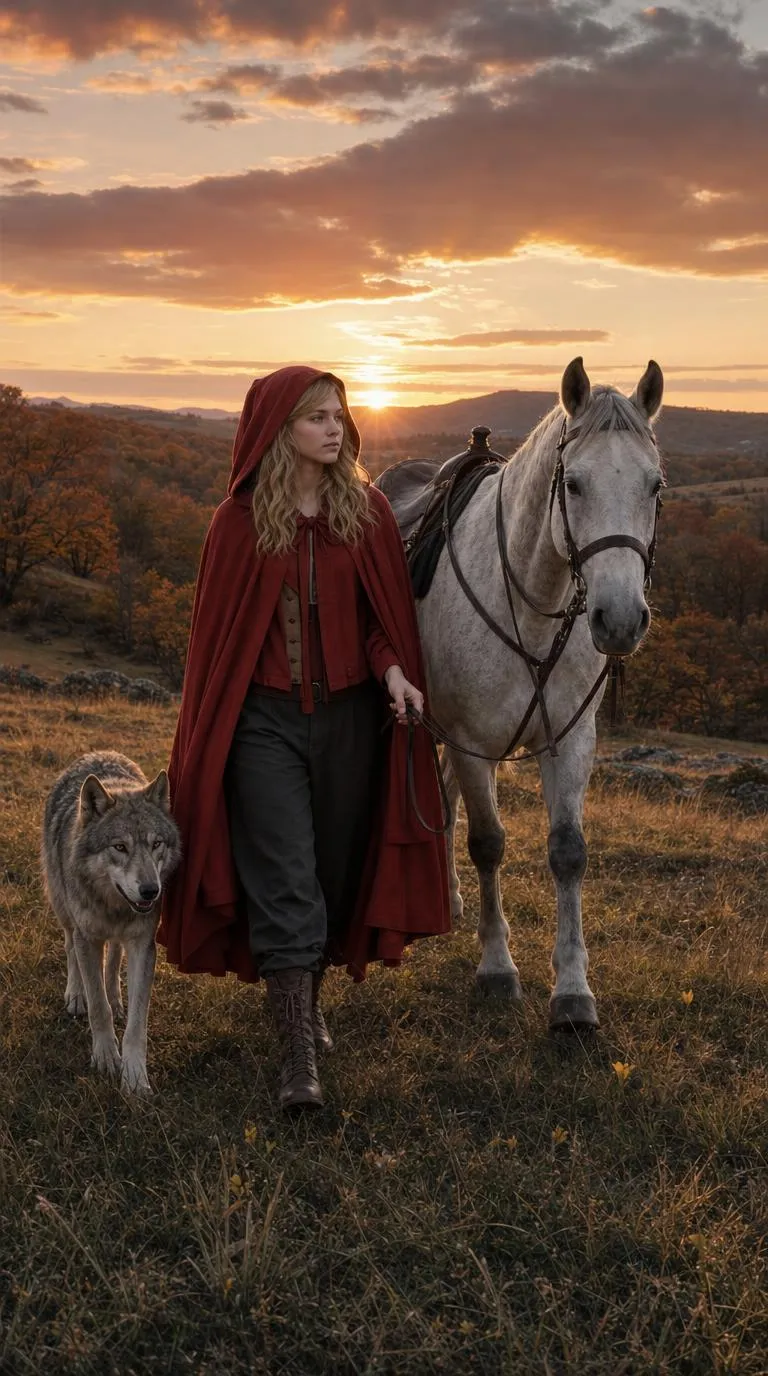
    Eine fotorealistische Szene, in der die junge Frau aus Referenzimage [01] mit ihrem Pferd [2] einige Meter auf einer Wiese spazieren geht, begleitet wird sie von ihrem zahmen Wolf [3]. Ihre große Kapuze vom Cape trägt sie nur locker auf ihrem Kopf, ihr Gesichtsausdruck ist entspannt und besinnlich und drückt innere Zufriedenheit aus.

    Die Landschaft ist eine herbstliche Hügellandschaft mit großen Weideflächen, die durch Laubbäume aufgelockert werden. Die Szene spielt am Abend, die Sonne steht kurz über dem Horizont und wirft ein warmes Licht auf die Landschaft. Die Wolken am Himmel bieten einen filmreifen Anblick.

    Fotorealistische, natürliche Beleuchtung, realistische Bewegungen. Format 9:16.

    Danach Übersetzung kontrolliert, ob die Rückübersetzung hält, war zufriedenstellend.

    Auch Nano Banana Pro kann stimmungsvollere Bilder liefern, nur von offenen Mund hatte ich nichts geschrieben.

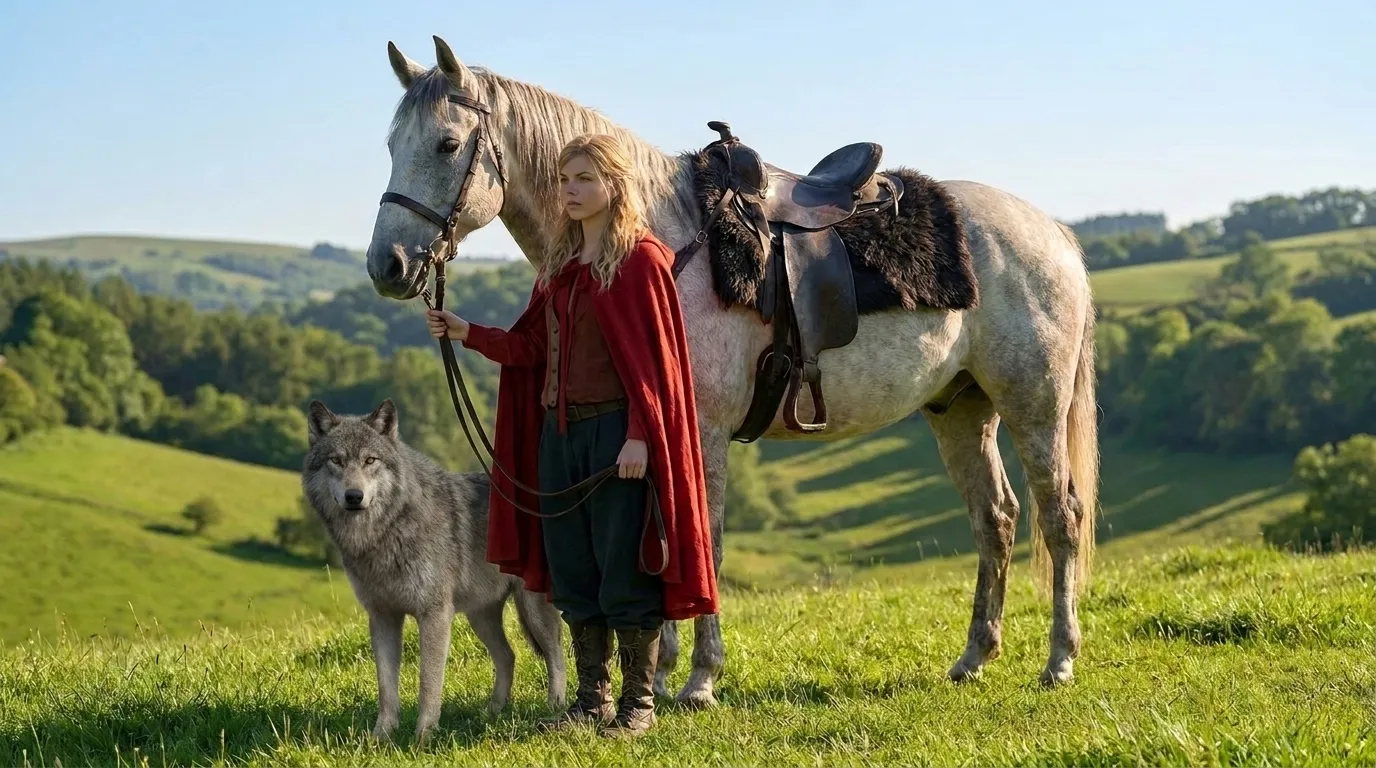
    Prompt unverändert in Leonardo mit GPT-Image-2 getestet. Reagierte nicht auf @, doch auf Referenzen. Diese halt ausgeschrieben. Dort muss ich aber bezahlen.

    Ergebnis, Satteldecke und Zaumzeug hat Abweichungen, das neuere Modell ist aber wohl GPT-Image-2.5 und das habe ich heute nicht benutzt:

    Wenn du noch einen Entwurf hast der dir nicht so gefallen hat...

    Ich habe keinen Plan bei ChatGPT, deshalb macht mir Chat im laufenden Chat nur ein Bild, bei der Fuchsfee waren es zwei. Beim Arbeitszimmer des Königs nur eins, weil Chat der Meinung war, das sollte genügen, damit andere KIs sich etwas an Hand der Einzelheiten konstruieren können. Habe aber bisher nicht ausgetestet, wie viele Bilder Chat bei kostenloser Benutzung erstellen würde, aber eine Schranke gibt es.

    Was es auch gibt, z.B. einen unbemerkten Modellwechsel unter der Haube. Ob bei ChatGPT weiß ich nicht, nur so allgemein bei LLM Modellen, das nach der fünften Antwort das Modell gegen ein schwächeres gewechselt würde, welches weniger "nachdenkt" hörte ich zumindest irgendwo einmal. Keine Ahnung, bei mir denkt Chat bisher nach, weil ich größere Pausen zwischendurch mache.

    Endlich ein Stückchen weiter. Im kostenlosen von ChatGPT bekam ich im ersten Versuch nur zwei Bilder hochgeladen, musste somit vorher meine drei Referenzen in einem Bild vereinen. Als zweites Bild einen Screenshot von YouTube, wobei ich starke Zweifel hatte, ob ich damit gegen das Urheberrecht oder gegen die Richtlinien von YT verstoße. Doch Chat meinte: "Wenn du mir den Screenshot hier zur Analyse hochlädst, sehe ich darin zunächst kein Problem."
    Gut, den Chat werde ich nicht teilen, weil meine Zweifel nicht restlos ausgeräumt sind.

    Die Aufteilung wurde ebenfalls so, dass ich rechts noch verkleinerte Shorts in Dauerschleife einbinden kann, ohne Videos in höherer Qualität fertigen zu müssen. Beim Zaumzeug und bei der Kleidung war die Image KI etwas großzügiger bei den Referenzen, wirklich stören tut es mich nicht.

    Also MJ ist für mich eine sehr eigenwillige und sehr freie Bilder Maschine...

    Ja, das kann ich mir vorstellen. Habe einmal bei YouTube gesucht, ein paar Tutorials gefunden, da ich aber nichts mit MJ mache, kommt mir die Vorgehensweise anders und eigenwilliger vor. Dieses Tutorial kann man sich in Deutsch bei YT anhören, ist aber noch mit Modell V7 erstellt und so würde ich bei keiner anderen Plattform vorgehen. Statt Dutzender Einzelbilder würde ich nur eine Referenz nehmen, und diese Ausdrücke erst in einer Szene wenn benötigt versuchen zu erstellen.

    Video ist bei YouTube auf Deutsch synchronisiert.

    Externer Inhalt www.youtube.com
    Inhalte von externen Seiten werden ohne Ihre Zustimmung nicht automatisch geladen und angezeigt.
    Durch die Aktivierung der externen Inhalte erklären Sie sich damit einverstanden, dass personenbezogene Daten an Drittplattformen übermittelt werden. Mehr Informationen dazu haben wir in unserer Datenschutzerklärung zur Verfügung gestellt.

    Meine monatlichen Credits für Flow sind bis zum 17.10. erschöpft, Tagescredits erhalte ich aber weiterhin, nur für mehr als zwei einfache Clips reichen diese dann nicht, es sei denn es handelt sich um Clips mit ganz einfachen Handlungen. Bilder kann ich weiterhin erstellen. Meine Credits von Kling oder Leonardo wollte ich nicht für den Song verballen.

    Da Meta ähnlich gute Ergebnisse wie MJ liefern kann, sollte ich es vielleicht einmal damit versuchen. Aber im Frühjahr hatte Meta immer 4 Entwürfe gemacht, nun noch einen, lässt sich zwar wiederholen, ist weniger gut. Werde einmal probieren, ob Vibes von Meta weiß. wie man auf ein Pferd aufsteigt. Falls dass klappen sollte, versuchen mir von ChatGPT ein ähnlich einem Plattencover in 16:9 erstellen zu lassen, um in diesen nur Reels als Schleife einzufügen. Das ist nach drei Tagen Nichtstun mein vorläufiger Plan, der ebenfalls scheitern könnte.

    Noch ein Hinweis von der Google KI, was bei MJ noch anders ist. Eine Charakter Referenz genügt, aber gleiches Bild zweimal einfügen, weil :

    Promptbeispiel: Ein Mann läuft durch den Park --cref [Bild-Link] --oref [Bild-Link]

    • Mit --cref merkt sich die KI das Gesicht.

    • Mit --oref merkt sich die KI die Kleidung und Ausrüstung.

    Ja, das sind gute Hinweise.... Danke!

    Gern geschehen, doch ich weiß ja nicht, was du ohnehin von alleine herausgefunden und getestet hast. Ich weiß nur, dass es sich bei Omni um einen plattformübergreifenden Standard handelt, mit dem ich anfänglich selbst nichts anzufangen wusste. Erst dachte ich, Omni ist irgend so ein Akronym, ist es aber nicht, sondern nur ein lateinischer Präfix für "alles" oder so ähnlich.

    Der sieht wirklich gut aus...

    Midjourney Omni soll nach dieser Anleitung bisher nur ein Referenzbild akzeptieren?

    Falsch gelesen, richtig ist:

    Midjourney akzeptiert im Ursprung genau ein Referenzbild pro Prompt für die ursprüngliche Omni-Reference-Funktion (--oref). In neueren Versionen (wie dem Edit Model in V8.1/V8.2) wurde der Ansatz weiterentwickelt, sodass dort bis zu vier Referenzen kombiniert werden können.

    Die Vorgehensweise unterscheidet sich nur etwas, aber dass Midjourney irgendwem dann nicht wie gewünscht kleiden möchte, gehört dadurch der Vergangenheit an.

    Zitat

    Mit einer Omni-Referenz können Sie Charaktere, Objekte, Fahrzeuge oder nicht-menschliche Kreaturen aus einem Referenzbild in Ihre Midjourney-Kreationen einfügen. https://docs.midjourney.com/hc/en-us/artic…-Omni-Reference

    Und es ist möglich, gleich Character Sheet von zwei Personen in einem Bild zu vereinen, dann solltest Du nie wieder Probleme habe. Da ist es vielleicht am günstigsten, die Referenzbilder von ChatGPT erstellen zu lassen, damit dann MJ die Pistole auf die Brust zu setzen, falls MJ nicht spurt.

    Eine andere Möglichkeit wäre, zwei Character Sheets mit Flow in 16:9 zu fertigen, dann die Leinwand zu vergrößern, sodas beide auf eine Leinwand passen, das zweite als Ebene mit einfügen. Dann ist es nur noch ein Referenzimage, nach dem sich MJ zu richten hätte.

    Zitat

    Während Sie nur ein Bild als Omni-Referenz verwenden können, können Sie versuchen, ein Bild zu verwenden, das mehrere Zeichen / Personen enthält, und sie in Ihrer Eingabeaufforderung beschreiben.

    Also, auch MJ ist nicht um den Omni als Standard herumgekommen.

    Nun noch einmal mit einem von mir optimierten Prompt.

    Prompt: Create a professional character turnaround sheet of a realistic grey wolf (Canis lupus). Piercing amber eyes, thick realistic fur texture. Turnaround model sheet showing front view, side profile view, three-quarter view, and back view . Plain light cream-colored neutral background. Photorealistic, ultra-detailed, DSLR photography quality, realistic skin texture, natural lighting, muted colors, thin borders, no watermark. Landscape format 16:9

    Das "light cream-colored" war in diesem Fall nur eine Notlösung, im Normalfall bei Kleidung und Personen sollte "Plain neutral background." die bessere Lösung sein. Und wer es lieber ohne Text mag, kann im letzten Satz noch "no text" einfügen.

    Nun machen wir gleich einen Test.
    Zur Vorbeugung von Verwechselungen schreibe ich meistens noch "from reference Image" mit in den Prompt, das "t" von "ftom" sah ich erst im Screenshot, doch das t liegt ja gleich neben dem r.

    Wichtiger ist, und das ist Standard für alle Image KIs und auch für alle Omni Video Modelle, Referenzbilder werden nicht über das Plus-Simbol zum Prompt hinzugefügt, sondern über das "@", dann werden die Links im Prompt aktiv geschaltet, ohne das man den Dateinamen eines Bildes angeben müsste. Also zukünftig daran denken, "@" eingeben im Prompt und das Zeichen wird automatisch durch einen aktiven Link vom ausgewählten Image ersetzt. Dann kann das auch praktisch nicht mehr passieren, dass die Kleidung sich verändert oder anderes. Für Wechselkleidung kann man extra Referenzen erstellen.

    Kling unterstützt gegenwärtig bis zu 7 Referenzimages, bei Seedance sollen es angeblich bis zu 50 pro Prompt sein, kam in einem Video Tutorial aber bereits bei 9 Charakteren durcheinander.

    Im Bild hat sich nun praktisch nichts verändert, es wurde nur der Wolf hinzugefügt.

    Aber wie verhält es sich nun mit Referenzen von Gebäuden, innen wie außen und anderen Kulissen?
    Mit Autos innen und außen sah ich bereits etwas, doch ohne Promptbeispiele.

    Noch ein Character Sheet, beide Prompts sind von der Google KI, beide ergaben Ansichten von vier Seiten.

    Rotkäppchen braucht ja noch einen Wolf.

    Prompt für dieses Bild:
    Character sheet of a realistic grey wolf (Canis lupus), amber eyes, thick fur, multiple angles, white background

    Dann noch einen etwas erweiterten Prompt, wobei die Ansichten nicht besser wurden:

    Professional wildlife character sheet of a realistic grey wolf (Canis lupus). Piercing amber eyes, thick realistic fur texture. Turnaround model sheet showing front view, side profile view, and three-quarter view. Clean, solid white background, studio lighting, hyper-detailed photography, National Geographic style.

    Morgen werde ich es noch einmal probieren, aber das "National Geographic style" herausnehmen oder einen anderen Style dafür einfügen. Auch das "Weiß" austauschen. Wenn es dabei nicht besser wird, sollte aber das obige bereits als Referenz genügen.

    3D workflows

    There have already been some excellent examples in the forum of how 3D can be enhanced and brought to life with AI. A thread by Salvador comes to mind, where he breathes new life into old 3D graphics.

    But creating characters with DAZ Studio and animating them with AI is also no problem. Instead of creating a character sheet with AI, you simply render four views in DAZ Studio.

    Eine KI hat keine eigenen neue Idee, aber das gesammelte Wissen von LLM (Large Language Modellen) Training übersteigt das von Bibliotheken, woraus sich wieder neue Inspirationen ergeben können. Über die "Zeit und Ewigkeit" hatte ich mir einmal eine kurze Geschichte schreiben lassen, diese war gar nicht so schlecht, ist aber nicht mehr online. Die Bilder dazu hatte ich wohl von Bing, falls ich mich richtig erinnern sollte, diese waren auch nicht schlecht. Einige schreiben wohl so ganze Bücher, in der Vorstellung, dadurch Geld verdienen zu können.

    Aber meinen letzten Songtext habe ich allein geschrieben, hat nicht lange gedauert, einfach was mir eingefallen ist. Nicht einmal eine Reimhilfe benötigt, trotzdem gut geworden. Nun ja, ist nicht lang. Eigentlich wollte ich nur probieren, eine nicht durchschnittliche Stimme für eine Sängerin zu kreieren, hat noch nicht zu 100 % geklappt. Deswegen habe ich eher nebenläufig etwas gereimt, damit die etwas zu singen hat, anschließend gefiel mir Text.

    Nun ist das Problem eher ein anderes, die lieben Credits, meine vorhandenen möchte ich lieber fürs Märchen aufsparen, eventuell noch für ein bis zwei Shorts. Sitze seit drei Tagen da und kommen mit dem Video für den Song kein Stück vorwärts. Wollte dann heute ein Einfaches mit dem FL Studio machen, doch irgendwie hat etwas gestreikt, war wohl überfordert. Jedenfalls mehrmals abgebrochen.

    Ein Video, welches zumindest diejenigen interessieren könnte, die nicht nur umherprobieren möchten, sondern ernsthaft konsistente Eigenschaften in Videos und Images zu erreichen. Einen Link har er in seinem ersten Kommentar angepinnt, von der Seite habe ich mir die Beispiele als PDF heruntergeladen, die für ChatGPT optimiert sind. Nutzt mir nicht viel, da ich kein Abo bei Chat habe, deswegen keine Images in 2K oder 4K erhalten würden. Nun ja, ich habe ja meine bisherigen Character Sheets, die ihren Zweck bisher erfüllten.

    Unterm Video ist weiterhin ein Post von X verlinkt, unter dem sich eine weitere Anleitung befindet. Auf YouTube lässt es sich mit deutschen Audiotrack anhören.

    Externer Inhalt www.youtube.com
    Inhalte von externen Seiten werden ohne Ihre Zustimmung nicht automatisch geladen und angezeigt.
    Durch die Aktivierung der externen Inhalte erklären Sie sich damit einverstanden, dass personenbezogene Daten an Drittplattformen übermittelt werden. Mehr Informationen dazu haben wir in unserer Datenschutzerklärung zur Verfügung gestellt.

    Dass KI kein Gedächtnis besitzt, mag ich als Laie kaum glauben.

    KIs haben ein "Gedächtnis" an Trainingsdaten und neuere sind je nach Modell zusätzlich noch lernfähig. Image KIs kennen z.B. den Triumphbogen aus allen Perspektiven.

    KIs haben aber kein Gedächtnis, was den menschlichen Erinnerungen an Objekten, Personen, Räumlichkeiten, Szenen usw. entspricht, mit denen sie nicht trainiert wurden. Eine Video KI weiß doch nach einem Clip nicht mehr, ob ein Auto rot, blau oder grün ausgesehen hat. Bei Image KIs gibt es zwar dafür eine Seed, aber nicht bei allen Modellen. Es liegt doch am Menschen, deshalb möglichst viele Referenzbilder zu erstellen.

    Auch die Außerirdischen (Gremlins?) hauen mich nicht wirklich vom Hocker.

    An wem liegt das? An den Menschen, die vor dem Computer sitzen, dass denen nichts Neues einfällt, würde ich meinen. Ist auch schwer, wobei bei diesen Außerirdischen ja ein gewisser Witz durchaus umgesetzt wurde.

    Als Schöpferin eigenständiger Resultate muss man sie hingegen nicht fürchten. Noch nicht, jedenfalls. Da steht KI wohl nach wie vor für »Keine Idee«.

    Du verstehst da irgendwie KI nicht. KI ist ein Werkzeug, der Mensch ist es, der dieses Werkzeug in die Hand nimmt und bedient, um seine Vorstellungen und Ideen umzusetzen. Filme oder Bilder entstehen noch immer zuerst im Kopf, da kommen doch die neuen Ideen her. Das Märchen, welches ich erst angefangen habe, das ist doch nicht KI. Es ist aber auch nicht neu, sondern gehört zu den kürzesten von den gesammelten Werken der Gebrüder Grimm, das sich seit meiner Kindheit nicht vergessen habe, weil da vortrefflich beschrieben wurde, was man sich unter Ewigkeit vorstellen kann.

    Zitat

    Sprach der König „die dritte Frage lautet: wie viel Sekunden hat die Ewigkeit?“ Da sagte das Hirtenbüblein „in Hinterpommern liegt der Demantberg, der hat eine Stunde in die Höhe, eine Stunde in die Breite und eine Stunde in die Tiefe; dahin kommt alle hundert Jahr ein Vöglein und wetzt sein Schnäbelein daran, und wenn der ganze Berg abgewetzt ist, dann ist die erste Sekunde von der Ewigkeit vorbei.“ Das Hirtenbüblein

    Auf Seite 20 hatte ich es verlinkt, hier noch einmal. Doch es ist erzählend geschrieben, außer den Fragen und Antworten enthält es keine Dialoge. Und das ist meine Idee, mit Dialogen zu arbeiten, ohne Geschichtenerzähler.

    Zitat

    Der König des Landes hörte auch davon, glaubte es nicht und ließ das Bübchen kommen.

    Ja vom wem hörte er es und durch wem ließ er es kommen?

    Das kann auch keine KI wissen, wenn es nicht überliefert ist. Aber ein Mensch kann es sich im Kopf vorstellen. An einen Berater des Königs dachte ich zuerst, doch als ich eines Morgens erwachte, dachte ich, eine Fee passt noch besser ins Märchen. Nun liegt es doch an mir, dafür die geeigneten Werkzeuge zu finden, um es umzusetzen. Wird nur länger dauern, als ursprünglich gedacht. Vielleicht auch nicht alles so perfekt werden, wie ich es mir wünschen würde, weil mein Budget sehr begrenzt ist. KI ist hingegen nur ein Werkzeug, um diese und andere Ideen umzusetzen.


    Außerdem habe ich noch etwas anderes angefangen. Ein Character Sheet für Rotkäppchen hatte ich oben bereits als Vorschau abgebildet. Heute damit ein erstes Bild generiert.

    Und damit das Pferd oder Zaumzeug und der Sattel im nächsten Clip nicht anders aussehen, vorsichtshalber aus dem Bild gleich dafür auch ein Referenzimage erstellt. Dafür aber keinen eigenen Prompt erstellt, weil der für Menschen nicht funktioniert hätte (Pferde sind größer), sondern den Agenten in Flow gebeten, mir ein Referenzblatt zu erstellen. Dann mir den Prompt kopiert und verwendet.

    Erster Versuch mit Flow Fast, Aufsteigen aufs Pferd wurde zur Katatrophe, zu komplex scheinbar, die KI kam nicht einmal auf die Idee, das eine Bein in den Steigbügel zu stecken und dann das andere übers Pferd zu heben.

    beweist er doch das Gegenteil dieser Aussage.

    Nehme einmal diese Auffahrrampe, beim Versuch diese zu schließen, nachdem das Auto ins Raumschiff fuhr. Bekommt die Video KI nicht hin, weil diese kein Gedächtnis besitzt, wie diese von unten aussah. Diese sieht beim Hoch- und Runterklappen immer beidseitig gleich aus. KI ist noch lange nicht so weit, du bekommst auch noch keine Gebäudeansichten von außen wie von innen fertig, nicht einmal einen Kameraschwenk innerhalb eines Raumes, der beim nächsten Schwenk noch genauso aussehen würde, weil Video KIs sich nicht erinnern können und Image KIs keine räumlichen Vorstellungen besitzen. Anders in 3D, hier kannst du ein Gebäude, Fahrzeug oder Raumschiff von innen und außen gestallten und in eine Umgebung einfügen, wobei alles erhalten bliebe. Davon könntest du dann entweder viele Bilder für Start- und Endframes erstellen, aber auch 360 Grad Aufnahmen. Also zuerst ein 3D Modell, dann erst mit KI animieren, wenn alles in Spielfimqualität stimmen soll. Was eines Tages nur mit KI möglich sein wird, weiß ist nicht, jedenfalls vorläufig ist es noch nicht soweit.

    Sah gerde einen Kurzfilm Higgsfield Global Film Festival, Titel "Oops First Contact" der mich an "E.T. – Der Außerirdische" erinnerte.

    Externer Inhalt www.youtube.com
    Inhalte von externen Seiten werden ohne Ihre Zustimmung nicht automatisch geladen und angezeigt.
    Durch die Aktivierung der externen Inhalte erklären Sie sich damit einverstanden, dass personenbezogene Daten an Drittplattformen übermittelt werden. Mehr Informationen dazu haben wir in unserer Datenschutzerklärung zur Verfügung gestellt.


    Kurze Unterhaltung dazu mit der Google KI:
    Experten und Branchen-Insider teilen deine Einschätzung vollkommen.
    [...]
    Hybrid-Produktionen: Anstatt VFX komplett zu verdrängen, wird KI vor allem als Werkzeug integriert. Vorhandene CGI-Modelle können durch KI realistischer beleuchtet, texturiert oder nahtlos in Realszenen eingebettet werden.

    Somit, KI wird CGI nicht verdrängen, nur als Werkzeug noch mehr integriert.